Una CNN en animaciones: perros y gatos
Versión resumida
Universidad Alfonso X el Sabio · Tema 2
Vamos a seguir a una sola foto de un perro mientras atraviesa una red neuronal convolucional, y a ver cómo la red aprende a mirarla.
| Paso | Qué vas a ver |
|---|---|
| 1 | Los datos y la foto que vamos a seguir |
| 2 | 🎬 La arquitectura de la red, construida paso a paso |
| 3 | 🎬 Qué es una convolución: una ventana que multiplica y suma |
| 4 | 🎬 El mismo perro con distintos filtros: cada filtro, una convolución distinta |
| 5 | 🎬 El pooling sobre la foto: cómo queda la imagen al reducirla |
| 6 | Entrenar la red (menos de un minuto) |
| 7 | 🎬 Cómo aprende los mapas de características, época a época |
| 8 | 🎬 La foto atravesando la red ya entrenada: dentro de un bloque, los cuatro bloques, la parte final (promedio, Flatten, Linear, sigmoide) y la red entera en una simulación |
| 9 | ¿Acierta? |
Cómo usarlo: ejecuta las celdas en orden (o Run All). En las animaciones 🎬 pulsa ▶, o usa los botones de paso para ir fotograma a fotograma.
La red es CNNMama, de ../solution/modelo.py: la misma del proyecto. Si
quieres todos los detalles, línea a línea, está el Cuaderno 1
(CNN_1_perros_gatos.ipynb).
código
# Si falta algo, descomenta, ejecuta una vez y reinicia el kernel:
# %pip install numpy pandas matplotlib pillow scikit-learn requests
# %pip install torch

from pathlib import Path
import sys, time
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from IPython.display import display
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset
from sklearn.model_selection import train_test_split
from sklearn.metrics import roc_auc_score, confusion_matrix

AQUI = next((p.resolve() for p in [Path.cwd(), Path.cwd() / 'ejemplo_clase',
                                    Path.cwd() / 'breastdcedl-usecase/ejemplo_clase']
             if (p / 'datos_perros_gatos.py').exists()), None)
if AQUI is None:
    raise FileNotFoundError('Abre el cuaderno desde la carpeta ejemplo_clase.')
for carpeta in (AQUI.parent / 'solution', AQUI):
    sys.path.insert(0, str(carpeta))

from modelo import CNNMama                           # LA red del proyecto
from dispositivo import semilla
from datos_perros_gatos import preparar, cargar_rgb  # 400 fotos, se descargan solas (~10 MB)
from dibujos import estilo, imagen, matriz
import animaciones as anim

estilo()
torch.set_num_threads(4)
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print('Dispositivo:', device)
Dispositivo: cpu
1. Los datos y la foto que vamos a seguir
400 fotos (200 gatos y 200 perros), reducidas a 64×64 píxeles y con cada píxel entre 0 y 1. Gato = 0, perro = 1. Usamos 300 para entrenar y apartamos 100 que la red nunca verá, para comprobar al final si acierta.
La foto que seguiremos es el primer perro de esas 100 apartadas: la red no la usa para aprender.
código
LADO = 64
tabla = preparar().reset_index(drop=True)
imagenes = np.stack([cargar_rgb(r, lado=LADO) for r in tabla.ruta])      # (400, 64, 64, 3)
etiquetas = tabla.clase.to_numpy(dtype=np.float32)
ids_train, ids_val = train_test_split(np.arange(len(etiquetas)), test_size=.25,
                                      stratify=etiquetas, random_state=42)
X = torch.tensor(imagenes).permute(0, 3, 1, 2).contiguous()               # (400, 3, 64, 64)
y = torch.tensor(etiquetas)

id_perro = int(ids_val[etiquetas[ids_val] == 1][0])                        # nuestro perro
foto = imagenes[id_perro]
foto_grande = cargar_rgb(tabla.ruta[id_perro], lado=224)                   # solo para verla bien
gris_grande = foto_grande @ np.array([.2126, .7152, .0722], dtype=np.float32)

fig, axes = plt.subplots(2, 7, figsize=(17, 5.4))
imagen(axes[0, 0], foto_grande, 'NUESTRO PERRO\n(la red no lo ve al entrenar)')
imagen(axes[1, 0], foto, 'lo que entra: 64×64')
for ax, i in zip(axes[:, 1:].ravel(), ids_train[:12]):
    imagen(ax, imagenes[i], 'perro' if etiquetas[i] else 'gato')
plt.tight_layout(); plt.show()
print(f'Entrenar: {len(ids_train)} fotos   ·   Comprobar: {len(ids_val)} fotos')

Entrenar: 300 fotos · Comprobar: 100 fotos
2. La arquitectura
La red son 4 bloques iguales y un final. Cada bloque hace cuatro cosas:
| Paso | Capa | Qué hace |
|---|---|---|
| 1 | Conv2d |
pasa varios filtros de 3×3 por la imagen: cada filtro da un mapa de características |
| 2 | BatchNorm2d |
pone cada mapa a una escala cómoda |
| 3 | ReLU |
apaga lo negativo: se queda con lo que el filtro sí ha encontrado |
| 4 | MaxPool2d |
parte el tamaño por 2, quedándose con lo más fuerte |
Al final, el promedio global resume cada mapa en un número (128 números),
una capa Linear los mezcla en uno solo y la sigmoide lo convierte en
P(perro).
Pulsa ▶ y fíjate en las dos reglas: la imagen encoge (64 → 4) y los mapas se multiplican (3 → 128).
código
anim.animar_arquitectura(LADO)
3. Qué es una convolución
Un filtro son 9 números en un cuadrado de 3×3. La convolución es:
- Coger una ventana de 3×3 píxeles.
- Multiplicar cada píxel por el número del filtro en su misma casilla.
- Sumar los 9 productos → un número en el resultado.
- Mover la ventana y repetir por toda la imagen.
$$\text{resultado}=\sum_{\text{9 casillas}}\text{píxel}\times\text{peso}$$
El filtro de la animación resta la columna izquierda y suma la derecha: da positivo (rojo) donde la derecha es más clara y negativo (azul) donde es más oscura. Es un detector de bordes verticales. La animación recorre un trozo de 8×8 de nuestro perro.
código
gris = foto @ np.array([.2126, .7152, .0722], dtype=np.float32)
fila, col = max(((r, c) for r in range(LADO - 8) for c in range(LADO - 8)),
                key=lambda rc: gris[rc[0]:rc[0] + 8, rc[1]:rc[1] + 8].std())   # el trozo con más contraste
bordes_verticales = np.array([[-1, 0, 1],
                              [-1, 0, 1],
                              [-1, 0, 1]], dtype=np.float32)
anim.animar_convolucion(gris[fila:fila + 8, col:col + 8], bordes_verticales, intervalo=450)
4. El mismo perro, distintos filtros
La idea más importante de todo el cuaderno: el cálculo es siempre el mismo (multiplicar y sumar). Lo único que cambia son los 9 números del filtro, y con ellos cambia por completo lo que sale.
En la animación el filtro se transforma poco a poco de uno a otro, y el resultado cambia a la vez. Fíjate también en cuánto suman sus 9 números:
- Si suman 0, el filtro es ciego al brillo: solo ve cambios (bordes). El resultado se pinta en rojo y azul según el signo.
- Si suman 1, conserva el brillo: el resultado sigue pareciendo la foto.
✋ Antes de pulsar ▶: ¿qué filtro crees que marcará mejor el contorno de las orejas? ¿Y cuál dejará la foto borrosa?
código
FILTROS = {
    'Identidad': ([[0, 0, 0], [0, 1, 0], [0, 0, 0]],
                  'Un 1 en el centro y ceros alrededor:\ncada píxel se queda igual.\nNo cambia nada.'),
    'Bordes verticales': ([[-1, 0, 1], [-2, 0, 2], [-1, 0, 1]],
                          'Resta la izquierda y suma la derecha.\nMarca los contornos de pie:\npatas, lados de la cara.'),
    'Bordes horizontales': ([[-1, -2, -1], [0, 0, 0], [1, 2, 1]],
                            'Resta arriba y suma abajo.\nMarca los contornos tumbados:\nlomo, ojos, boca.'),
    'Bordes diagonales': ([[0, 1, 2], [-1, 0, 1], [-2, -1, 0]],
                          'Compara una esquina con la opuesta.\nMarca las líneas inclinadas.'),
    'Todos los bordes': ([[-1, -1, -1], [-1, 8, -1], [-1, -1, -1]],
                         'El centro contra sus 8 vecinos.\nMarca cualquier cambio,\nen cualquier dirección.'),
    'Difuminar': ([[1 / 9] * 3] * 3,
                  'La media de los 9 píxeles.\nBorra el detalle fino:\nla foto queda borrosa.'),
    'Realzar': ([[0, -1, 0], [-1, 5, -1], [0, -1, 0]],
                'La foto más sus bordes.\nResalta el detalle: pelo, bigotes.'),
    'Relieve': ([[-2, -1, 0], [-1, 1, 1], [0, 1, 2]],
                'Una diagonal oscura y otra clara:\nparece iluminada desde un lado.'),
}
anim.animar_filtros_foto(gris_grande, FILTROS)
Y ahora la pregunta clave: ¿quién elige esos 9 números en la red?
Nadie. Al principio son números al azar. Entrenar es, precisamente, ir cambiándolos hasta que los mapas que salen sirvan para distinguir perros de gatos. En la primera capa hay 16 filtros, cada uno con 27 números (9 por cada color). Cada filtro produce un mapa de características: la foto «vista» por ese filtro.
Prueba tú
Cambia los 9 números y ejecuta. ¿Qué resalta tu filtro? ¿Cuánto suman?
código
mi_filtro = np.array([[ 1,  1,  1],
                      [ 0,  0,  0],
                      [-1, -1, -1]], dtype=np.float32)

salida = anim._convolucion_numpy(gris_grande, mi_filtro)
fig, axes = plt.subplots(1, 2, figsize=(9, 4.3))
imagen(axes[0], gris_grande, 'la foto', cmap='gray', vmin=0, vmax=1)
tope = np.percentile(np.abs(salida), 99.5)
imagen(axes[1], salida, f'tu filtro (sus números suman {mi_filtro.sum():g})',
       cmap='RdBu_r' if abs(mi_filtro.sum()) < .05 else 'gray',
       vmin=-tope if abs(mi_filtro.sum()) < .05 else None, vmax=tope if abs(mi_filtro.sum()) < .05 else None)
plt.tight_layout(); plt.show()

5. El pooling: la foto a la mitad
Después de la convolución, cada bloque termina con un MaxPool2d(2): divide la imagen en cuadritos de 2×2 y de cada uno se queda con el número más grande. La imagen pasa a tener la mitad de alto y la mitad de ancho: 4 veces menos números.
| MaxPool | AvgPool | |
|---|---|---|
| De cada 2×2 se queda con… | el mayor | la media |
| Un borde fuerte… | sobrevive | se suaviza |
| Lo usa nuestra red | sí, en los 4 bloques | no |
¿Por qué tirar 3 de cada 4 números? Por dos motivos:
- Coste: cada bloque siguiente trabaja con 4 veces menos números.
- Tolerancia: si algo se mueve un píxel dentro del mismo cuadrito, el máximo no cambia. A la red le importa menos la posición exacta.
5.1. La ventana 2×2 sobre un trozo del perro
Un trozo de 8×8 píxeles de nuestro perro (en gris). El marco naranja es el cuadrito 2×2; el verde, el número que sobrevive.
código
fila_p, col_p = max(((r, c) for r in range(0, LADO - 8, 2) for c in range(0, LADO - 8, 2)),
                    key=lambda rc: gris[rc[0]:rc[0] + 8, rc[1]:rc[1] + 8].std())   # el trozo con más contraste
anim.animar_maxpool(gris[fila_p:fila_p + 8, col_p:col_p + 8])
5.2. La foto entera, pooling tras pooling
Arriba, la foto. Abajo, lo que resalta un filtro de bordes verticales (lo que saldría de una convolución + ReLU). Cada fotograma aplica un pooling más: 64 → 32 → 16 → 8 → 4, como los cuatro bloques de la red.
Compara en cada fila MaxPool (centro) con AvgPool (derecha): con MaxPool los bordes siguen brillando; con AvgPool se van apagando. El último fotograma mueve la foto un píxel y mide cuánto cambia el mapa antes y después del pooling.
✋ Predice: tras cuatro poolings (4×4 píxeles), ¿se reconocerá el perro?
código
anim.animar_pooling_foto(foto)
6. Entrenar
Entrenar es repetir muchas veces cinco pasos:
| Paso | Código | Qué hace |
|---|---|---|
| 1 | optimizador.zero_grad() |
borra las correcciones anteriores |
| 2 | prediccion = red(fotos) |
32 fotos atraviesan la red |
| 3 | perdida = criterio(prediccion, respuestas) |
mide cuánto se ha equivocado |
| 4 | perdida.backward() |
calcula hacia dónde mover cada número de la red |
| 5 | optimizador.step() |
mueve los 97.809 números un poquito en esa dirección |
Una época es una pasada por las 300 fotos. Hacemos 20. Además, a cada foto le damos la vuelta de izquierda a derecha con probabilidad ½ (un perro del revés sigue siendo un perro).
Mientras entrena, guardamos en cada época los filtros, los mapas de características de nuestro perro y la probabilidad que le da la red. Con eso haremos la animación de la sección 7.
⏱️ Menos de un minuto en CPU.
código
EPOCAS, LOTE, PASO = 20, 32, 5e-4

semilla(42)
red = CNNMama().to(device)
criterio = nn.BCEWithLogitsLoss()
optimizador = torch.optim.AdamW(red.parameters(), lr=PASO, weight_decay=1e-4)
planificador = torch.optim.lr_scheduler.CosineAnnealingLR(optimizador, T_max=EPOCAS)
cargador = DataLoader(TensorDataset(X[ids_train], y[ids_train]), batch_size=LOTE,
                      shuffle=True, drop_last=True, generator=torch.Generator().manual_seed(42))
x_perro = X[[id_perro]].to(device)


def predecir(ids):
    red.eval()
    with torch.inference_mode():
        return torch.cat([red(X[ids[i:i + 64]].to(device)).cpu() for i in range(0, len(ids), 64)])


def fotografiar(epoca):
    """Guarda cómo está la red en esta época."""
    fila = {'época': epoca}
    for parte, ids in [('entrenar', ids_train), ('comprobar', ids_val)]:
        salida = predecir(ids)
        fila[f'perdida_{parte}'] = criterio(salida, y[ids]).item()
        fila[f'acierto_{parte}'] = ((salida >= 0) == y[ids].bool()).float().mean().item()
    historial.append(fila)
    with torch.inference_mode():
        filtros_ep.append(red.bloque1[0].weight.detach().cpu().numpy().copy())
        mapas1_ep.append(red.bloque1[:3](x_perro)[0].cpu().numpy())               # Conv+BN+ReLU del bloque 1
        mapas2_ep.append(red.bloque2[:3](red.bloque1(x_perro))[0].cpu().numpy())  # y del bloque 2
        prob_perro_ep.append(red(x_perro).sigmoid().item())


historial, filtros_ep, mapas1_ep, mapas2_ep, prob_perro_ep = [], [], [], [], []
fotografiar(0)
reloj = time.perf_counter()
for epoca in range(1, EPOCAS + 1):
    red.train()
    for fotos, respuestas in cargador:
        fotos, respuestas = fotos.to(device), respuestas.to(device)
        voltear = torch.rand(len(fotos)) < .5
        fotos = torch.where(voltear[:, None, None, None].to(device), fotos.flip(3), fotos)
        optimizador.zero_grad()                          # 1
        prediccion = red(fotos)                          # 2
        perdida = criterio(prediccion, respuestas)       # 3
        perdida.backward()                               # 4
        optimizador.step()                               # 5
    planificador.step()
    fotografiar(epoca)
    print(f'época {epoca:2d}/{EPOCAS}   error {historial[-1]["perdida_entrenar"]:.3f}   '
          f'acierto en fotos nuevas {historial[-1]["acierto_comprobar"]:.0%}   '
          f'P(perro) de nuestro perro {prob_perro_ep[-1]:.2f}', flush=True)
historial = pd.DataFrame(historial)
red.eval()
print(f'\nTerminado en {time.perf_counter() - reloj:.0f} s.')

fig, axes = plt.subplots(1, 2, figsize=(13, 3.8))
for parte, color in [('entrenar', 'tab:blue'), ('comprobar', 'tab:orange')]:
    axes[0].plot(historial['época'], historial['perdida_' + parte], 'o-', ms=4, color=color, label=parte)
    axes[1].plot(historial['época'], historial['acierto_' + parte], 'o-', ms=4, color=color, label=parte)
axes[0].set(title='El error baja', xlabel='época')
axes[1].set(title='El acierto sube', xlabel='época', ylim=(.4, 1))
axes[1].axhline(.5, color='gray', ls=':')
for ax in axes:
    ax.legend(); ax.grid(alpha=.2)
plt.tight_layout(); plt.show()
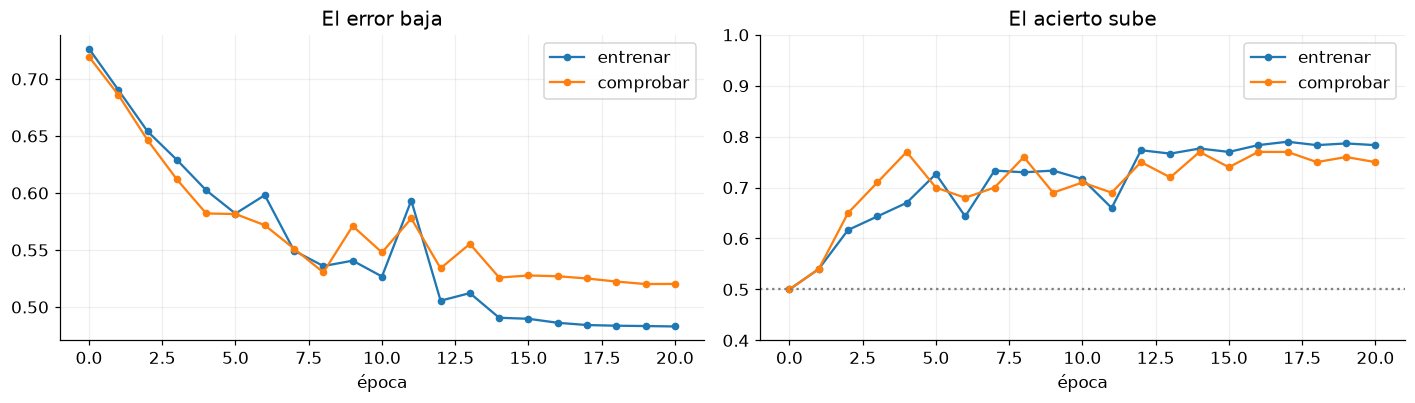
época 1/20 error 0.690 acierto en fotos nuevas 54% P(perro) de nuestro perro 0.45
época 2/20 error 0.654 acierto en fotos nuevas 65% P(perro) de nuestro perro 0.54
época 3/20 error 0.629 acierto en fotos nuevas 71% P(perro) de nuestro perro 0.53
época 4/20 error 0.602 acierto en fotos nuevas 77% P(perro) de nuestro perro 0.58
época 5/20 error 0.582 acierto en fotos nuevas 70% P(perro) de nuestro perro 0.59
época 6/20 error 0.598 acierto en fotos nuevas 68% P(perro) de nuestro perro 0.77
época 7/20 error 0.549 acierto en fotos nuevas 70% P(perro) de nuestro perro 0.62
época 8/20 error 0.536 acierto en fotos nuevas 76% P(perro) de nuestro perro 0.66
época 9/20 error 0.541 acierto en fotos nuevas 69% P(perro) de nuestro perro 0.65
época 10/20 error 0.527 acierto en fotos nuevas 71% P(perro) de nuestro perro 0.80
época 11/20 error 0.593 acierto en fotos nuevas 69% P(perro) de nuestro perro 0.84
época 12/20 error 0.506 acierto en fotos nuevas 75% P(perro) de nuestro perro 0.68
época 13/20 error 0.512 acierto en fotos nuevas 72% P(perro) de nuestro perro 0.67
época 14/20 error 0.491 acierto en fotos nuevas 77% P(perro) de nuestro perro 0.76
época 15/20 error 0.490 acierto en fotos nuevas 74% P(perro) de nuestro perro 0.72
época 16/20 error 0.486 acierto en fotos nuevas 77% P(perro) de nuestro perro 0.75
época 17/20 error 0.484 acierto en fotos nuevas 77% P(perro) de nuestro perro 0.75
época 18/20 error 0.484 acierto en fotos nuevas 75% P(perro) de nuestro perro 0.76
época 19/20 error 0.483 acierto en fotos nuevas 76% P(perro) de nuestro perro 0.76
época 20/20 error 0.483 acierto en fotos nuevas 75% P(perro) de nuestro perro 0.75
Terminado en 18 s.
7. Cómo aprende la red sus mapas de características
Esta es la animación central. Cada fotograma es una época del entrenamiento, y en todas se ve la misma foto de nuestro perro:
- Arriba: 8 de los 16 filtros del bloque 1, pintados como cuadraditos de color de 3×3. Son los números que la red va cambiando.
- En medio: el mapa de características que produce cada uno de esos filtros sobre el perro (brillante = el filtro ha encontrado «lo suyo» ahí).
- Abajo: 8 mapas del bloque 2, que no miran la foto sino los mapas del bloque 1: combinan bordes y colores en formas más complejas.
- A la izquierda: la probabilidad de que sea un perro. A la derecha: el error y el acierto.
✋ Fíjate en esto: en la época 0 los filtros son ruido y los mapas no tienen forma. Con las épocas, los mapas del bloque 1 empiezan a marcar contornos, zonas claras y oscuras y colores, y los del bloque 2 se concentran en partes del perro.
código
anim.animar_mapas_aprendiendo(foto, filtros_ep, mapas1_ep, mapas2_ep, historial, prob_perro_ep,
                              es_perro=True)
Lo que hay que llevarse de esta animación:
- Nadie le dice a la red «busca orejas». Los filtros se ajustan solos porque así baja el error.
- Los primeros mapas son sencillos (bordes, colores) y los siguientes combinan los anteriores. Cuanto más profundo el bloque, más abstracto lo que responde.
- Un mapa no es «un perro»: es dónde ha encontrado su patrón un filtro. La decisión sale de juntar muchos mapas.
8. La foto atraviesa la red, paso a paso
8.1. Dentro del primer bloque
Las cuatro capas del bloque 1, una por fotograma, sobre nuestro perro y con la red ya entrenada. En cada paso se ven los 8 mapas que más responden. Mira el tamaño en el título: solo cambia en el último paso.
código
with torch.inference_mode():
    tras_conv = red.bloque1[0](x_perro)
    tras_bn = red.bloque1[1](tras_conv)
    tras_relu = red.bloque1[2](tras_bn)
    tras_pool = red.bloque1[3](tras_relu)

etapas_bloque = [
    ('la entrada', 'Tres mapas: el rojo, el verde y el azul de la foto.', x_perro[0]),
    ('Conv2d (16 filtros)', 'Cada filtro da un mapa. Rojo = el filtro responde a favor; azul = en contra.', tras_conv[0]),
    ('BatchNorm2d', 'Los mismos mapas, puestos a una escala parecida entre sí.', tras_bn[0]),
    ('ReLU', 'Lo negativo se apaga: solo queda lo que cada filtro SÍ ha encontrado.', tras_relu[0]),
    ('MaxPool2d', 'La mitad de tamaño: de cada cuadrito 2×2 se queda lo más fuerte.', tras_pool[0]),
]
anim.animar_etapas(foto, [(t, e, m.cpu().numpy()) for t, e, m in etapas_bloque])
8.2. Los cuatro bloques
Ahora de bloque en bloque. Los mapas se hacen más pequeños y más abstractos: al final son cuadritos de 4×4 donde ya no se reconoce la foto. No es un problema, es la idea: lo que queda no es la imagen, sino qué cosas ha encontrado la red y con cuánta fuerza.
código
with torch.inference_mode():
    salidas, paso = [('la entrada', 'La foto: 3 mapas (rojo, verde, azul) de 64×64.', x_perro[0])], x_perro
    explicaciones = ['Bordes, colores y manchas.',
                     'Combinaciones de bordes: esquinas, texturas.',
                     'Partes más grandes: formas, zonas del cuerpo.',
                     'Muy abstracto: cada mapa de 4×4 dice cuánto hay de «algo» y dónde, a grandes rasgos.']
    for b, explicacion in zip(['bloque1', 'bloque2', 'bloque3', 'bloque4'], explicaciones):
        paso = getattr(red, b)(paso)
        salidas.append((b, explicacion, paso[0]))
    p_perro = red(x_perro).sigmoid().item()

anim.animar_etapas(foto, [(t, e, m.cpu().numpy()) for t, e, m in salidas], intervalo=3000)
8.3. La parte final de la red: de 128 mapas a una probabilidad
Después del bloque 4 quedan 128 mapas de 4×4. Las últimas líneas de
modelo.py los convierten en un solo número:
self.promedio = nn.AdaptiveAvgPool2d(1)                                    # 1. promedio global
self.clasificador = nn.Sequential(nn.Flatten(),                            # 2. Flatten
                                  nn.Dropout(0.3),                         # 3. Dropout
                                  nn.Linear(128, 1))                       # 4. Linear
# y la sigmoide convierte el resultado en probabilidad                     # 5. sigmoide
| Paso | Qué hace | Forma |
|---|---|---|
| salen del bloque 4 | 128 mapas | (1, 128, 4, 4) |
| 1. promedio global | de cada mapa, su media | (1, 128, 1, 1) |
| 2. Flatten | desenrolla: pone todo en una fila, sin calcular nada | (1, 128) |
| 3. Dropout | al entrenar apaga números al azar; al evaluar no hace nada | (1, 128) |
| 4. Linear | multiplica cada número por su peso y lo suma todo, más un sesgo | (1, 1): el logit |
| 5. sigmoide | convierte el logit en probabilidad | P(perro) |
La animación usa los números reales de nuestro perro. Empieza enseñando qué es Flatten con un solo mapa (desenrollar 4×4 en 16) y por qué la red no desenrolla los 128 mapas enteros.
código
with torch.inference_mode():
    mapas_b4 = salidas[-1][2]                                       # (128, 4, 4): lo que sale del bloque 4
    vector = red.promedio(mapas_b4[None]).flatten(1)[0]             # promedio global + Flatten: (128,)
    lineal = red.clasificador[-1]
    pesos_lineal, sesgo_lineal = lineal.weight[0].detach().cpu(), lineal.bias.item()
    z_perro = red(x_perro).item()
# Comprobación: la suma a mano es exactamente el logit de la red.
assert abs((vector.cpu() @ pesos_lineal).item() + sesgo_lineal - z_perro) < 1e-4
print(f'bloque 4: {tuple(mapas_b4.shape)}  →  promedio + Flatten: {tuple(vector.shape)}  →  '
      f'Linear: z = {z_perro:+.3f}  →  sigmoide: P(perro) = {p_perro:.2f}')

anim.animar_final_red(foto, mapas_b4.cpu().numpy(), pesos_lineal.numpy(), sesgo_lineal)
bloque 4: (128, 4, 4) → promedio + Flatten: (128,) → Linear: z = +1.073 → sigmoide: P(perro) = 0.75
8.4. La red entera, en una simulación
Todo junto, de izquierda a derecha. Cada caja es lo que sale de verdad de esa parte de la red para nuestro perro: la foto; los mosaicos con todos los mapas de cada bloque (16, 32, 64 y 128, cada vez más pequeños); los 128 números del promedio global; la suma ponderada de Linear; y la probabilidad final.
código
bloques = [m.cpu().numpy() for _, _, m in salidas[1:]]              # los 4 bloques de la sección 8.2
anim.animar_red_simulacion(foto, bloques, vector.cpu().numpy(), pesos_lineal.numpy(), sesgo_lineal)
código
print('Nuestro perro era de las fotos que la red nunca vio al entrenar.',
      '¡Acierta!' if p_perro >= .5 else 'Esta vez se equivoca: le da menos de 0,5.')
Nuestro perro era de las fotos que la red nunca vio al entrenar. ¡Acierta!
9. ¿Acierta?
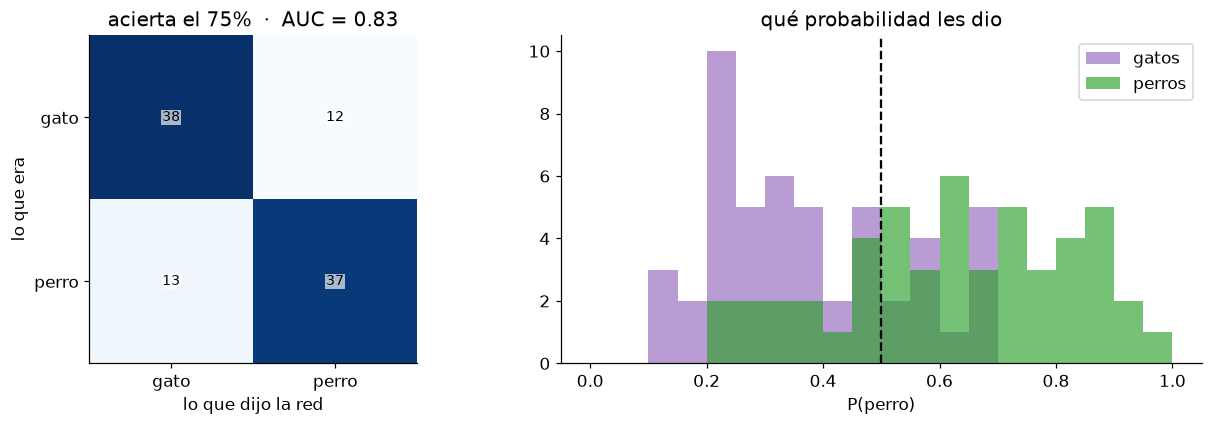
Con las 100 fotos apartadas. Con solo 300 fotos para aprender y una red que empieza de cero, acertar alrededor de 3 de cada 4 es un buen resultado.
código
probs = predecir(ids_val).sigmoid().numpy()
verdad = etiquetas[ids_val]
cm = confusion_matrix(verdad, probs >= .5, labels=[0, 1])

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
matriz(axes[0], cm, f'acierta el {cm.trace() / cm.sum():.0%}  ·  AUC = {roc_auc_score(verdad, probs):.2f}', fmt='.0f')
axes[0].set(xlabel='lo que dijo la red', ylabel='lo que era', xticks=[0, 1], yticks=[0, 1],
            xticklabels=['gato', 'perro'], yticklabels=['gato', 'perro'])
axes[1].hist(probs[verdad == 0], bins=20, range=(0, 1), alpha=.65, label='gatos', color='tab:purple')
axes[1].hist(probs[verdad == 1], bins=20, range=(0, 1), alpha=.65, label='perros', color='tab:green')
axes[1].axvline(.5, color='black', ls='--')
axes[1].set(title='qué probabilidad les dio', xlabel='P(perro)')
axes[1].legend()
plt.tight_layout(); plt.show()

fig, axes = plt.subplots(2, 8, figsize=(18, 6))
for ax, i in zip(axes.ravel(), range(16)):
    acierto = (probs[i] >= .5) == bool(verdad[i])
    imagen(ax, imagenes[ids_val[i]], f"era {'perro' if verdad[i] else 'gato'}\nP(perro) = {probs[i]:.2f}")
    ax.title.set_color('tab:green' if acierto else 'tab:red')
fig.suptitle('16 fotos nuevas: verde = acierta, rojo = falla', fontsize=14)
plt.tight_layout(h_pad=2); plt.show()

Resumen
- Una foto es una tabla de números.
- Una convolución es multiplicar y sumar con una ventana que recorre la imagen.
- Cambiar los 9 números del filtro cambia lo que resalta: bordes, desenfoque, detalle...
- El pooling reduce la imagen a la mitad quedándose con lo más fuerte: menos números y más tolerancia a pequeños desplazamientos.
- Cada filtro produce un mapa de características. La red empieza con filtros al azar y los ajusta sola mientras entrena.
- Bloque a bloque, los mapas son más pequeños y más abstractos.
- Al final, el promedio global deja 128 números, Flatten los pone en fila, Linear los suma con sus pesos y la sigmoide da la probabilidad.
Cinco preguntas
- Si dos filtros hacen exactamente el mismo cálculo, ¿por qué dan resultados tan distintos?
- ¿Quién decide qué filtros usa la red?
- ¿Por qué los mapas del bloque 4 ya no se parecen a la foto?
- Tras cuatro MaxPool, ¿de qué tamaño queda una imagen de 64×64? ¿Cuántos números aprende un MaxPool?
- ¿Qué calcula Flatten?
Ver las respuestas
- Porque tienen números distintos. El cálculo es igual; los pesos no.
- Nadie: empiezan al azar y el entrenamiento los cambia para que baje el error.
- Porque cada bloque reduce el tamaño a la mitad y combina los mapas anteriores. Ya no guardan la imagen, sino qué patrones hay y con qué fuerza.
- $64 \to 32 \to 16 \to 8 \to 4$: 4×4. Un MaxPool no aprende nada: no tiene pesos, solo elige el mayor.
- Nada: solo cambia la forma, poniendo todos los números en una fila. En nuestra red, de (128, 1, 1) a (128,).
Para saber más: CNN_1_perros_gatos.ipynb (la versión completa, línea a
línea) y CNN_2_resonancias_mama.ipynb (la misma red con resonancias de mama).